Как настроить эмпатичного ИИ-ассистента: системные промпты, RAG и TTS для естественного общения

Паспорт гайда
- Время на реализацию: 60–90 минут
- Стек / Инструменты: Python 3 +
venv, пакетrequests, OpenAI-совместимый LLM-эндпоинт (/chat/completions), модель эмбеддингов (/embeddings), TTS-сервис с HTTP API, 2–3 текстовых файла базы знаний - Уровень: Intermediate
Архитектурный контекст
Эмпатия в ассистенте — не свойство модели, а следствие трёх независимых слоёв поверх одного LLM-вызова:
1. Системный промпт — задаёт роль, тон и жёсткие границы. Это единственный слой, который управляет формой ответа.
2. RAG — поиск по вашим документам, чтобы факты (сроки, условия, цены) не выдумывались моделью. Технически: чанки → векторы эмбеддингов → косинусный поиск top-K → вставка в системный промпт.
3. TTS — синтез речи из готового текста. Работает уже после LLM и не влияет на содержание ответа.
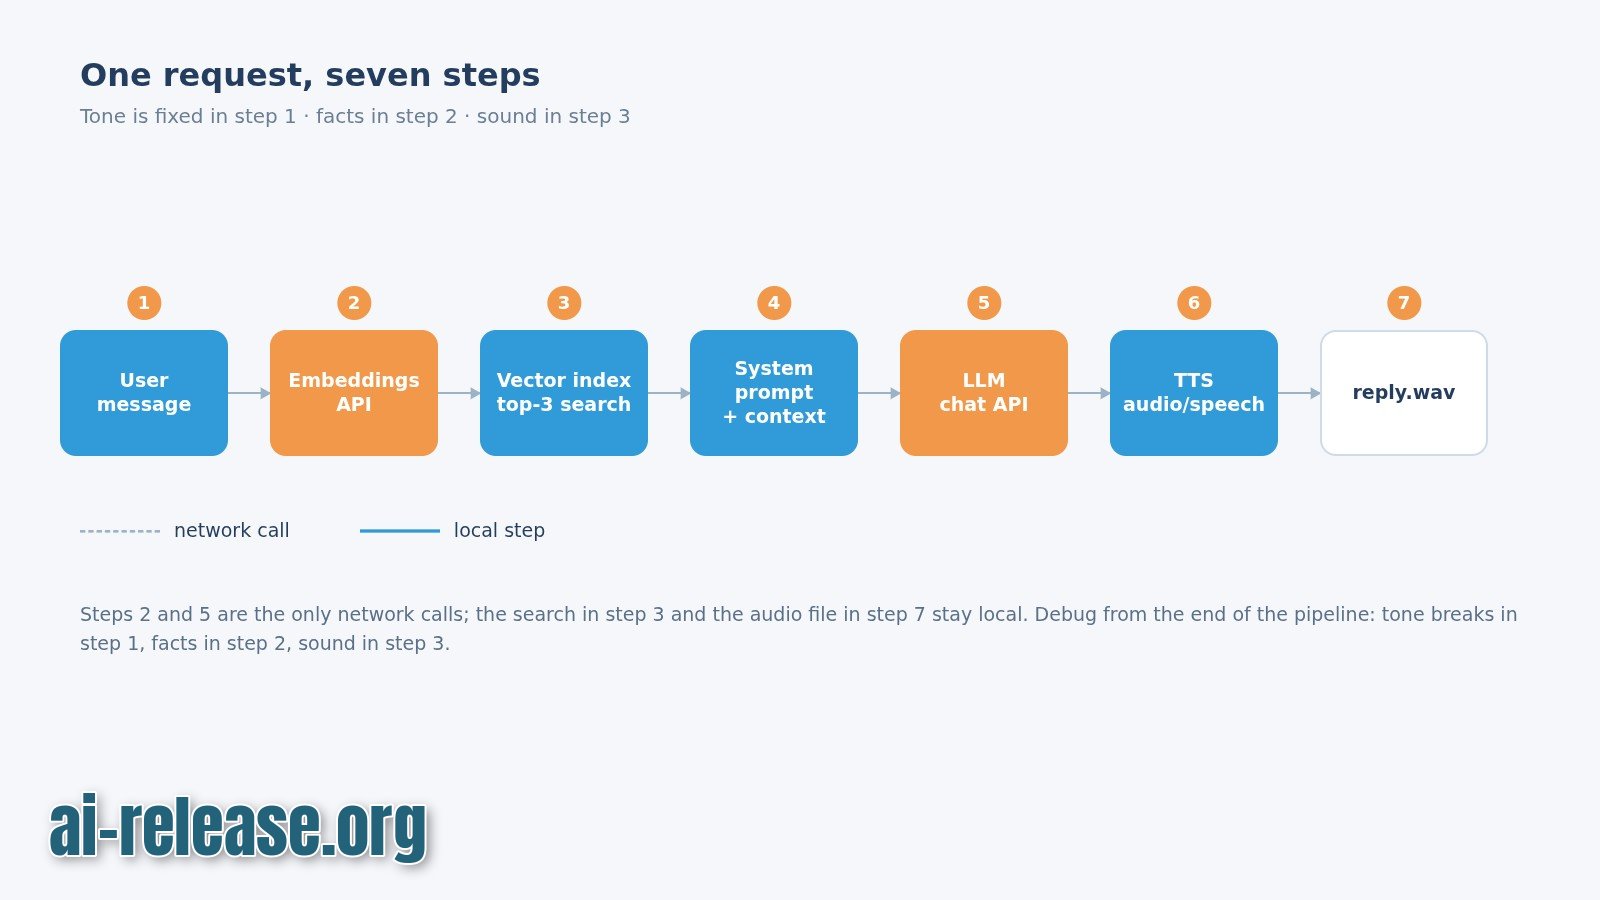
Поток данных одного запроса:
реплика пользователя
  → embed(query)                         [embeddings API]
  → cosine top-3 по index/index.json     [локально, ~1 мс]
  → system_prompt.txt + "Контекст: …"    [склейка]
  → /chat/completions                    [LLM]
  → reply.txt
  → /audio/speech                        [TTS]
  → reply.wav
Ключевое следствие для отладки: тон ломается на шаге 1, факты — на шаге 2, звук — на шаге 3. Диагностика идёт с конца конвейера, а не «в целом по боту».
Если нужен общий обзор инструментов и готовых сборок перед настройкой — см. гайд «Как сделать голосового ИИ-ассистента на компьютере».
Шаг 1. Системный промпт: фиксируем тон, формат и границы
Что сделать: положить правила в system_prompt.txt и отправлять их вместе с репликой пользователя через chat.py.
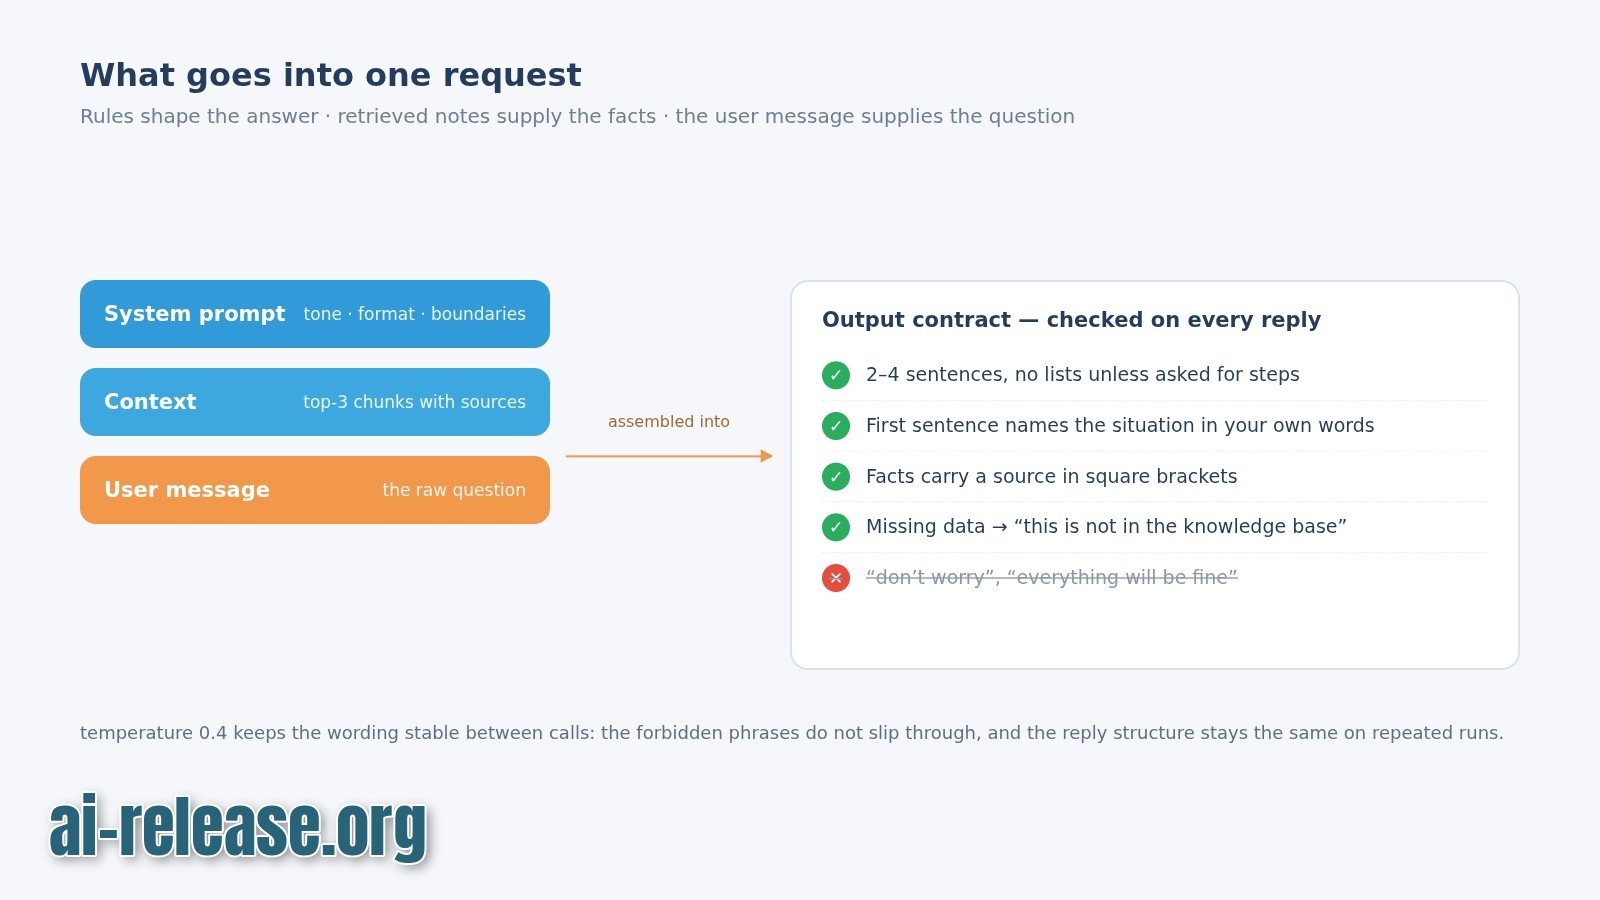
Зачем: модель по умолчанию отвечает в «дежурном» стиле поддержки. Эмпатия появляется, когда правилами заданы три вещи: сначала назвать ситуацию собеседника своими словами, не использовать шаблонные утешения, не превращать ответ в список, если человеку нужна одна фраза.
Подготовка окружения и структуры проекта:
python3 -m venv .venv
source .venv/bin/activate
pip install requests
mkdir -p ~/empathy-assistant/{data,index}
cd ~/empathy-assistant
cat > .env <<'EOF'
LLM_BASE_URL=https://<ваш-домен>/v1
LLM_API_KEY=<ключ-LLM>
LLM_MODEL=<имя-модели-из-документации>
EMBED_BASE_URL=https://<ваш-домен>/v1
EMBED_API_KEY=<ключ-эмбеддингов>
EMBED_MODEL=<имя-эмбеддинг-модели>
TTS_BASE_URL=https://<ваш-домен>/v1
TTS_API_KEY=<ключ-TTS>
TTS_MODEL=<имя-TTS-модели>
TTS_VOICE=<голос-из-списка-сервиса>
EOF| Переменная | Пример значения | Критично, потому что |
|---|---|---|
| `LLM_BASE_URL` | `https://<ваш-домен>/v1` | к корню дописываются пути `/chat/completions` и `/embeddings`; лишний `/v1` или его отсутствие даёт 404 |
| `LLM_MODEL` | `<имя-модели-из-документации>` | имя строковое, регистрозависимое; список — только в документации провайдера |
| `EMBED_MODEL` | `<имя-эмбеддинг-модели>` | индекс и запрос обязаны кодироваться одной моделью, иначе близость векторов теряет смысл |
| `TTS_VOICE` | `<голос-из-списка-сервиса>` | несуществующий голос возвращает 200 с телом ошибки, а не 4xx |
Файл правил system_prompt.txt:
Ты — ассистент поддержки. Отвечай по-русски, обращение на «вы».

Тон:
- Первой фразой назови эмоцию или ситуацию собеседника своими словами.
- Не используй обороты «не переживайте», «всё будет хорошо», «я понимаю ваши чувства».
- Не оценивай чувства как правильные или неправильные.

Формат:
- До 4 предложений, без списков и заголовков, если пользователь не попросил пошаговую инструкцию.
- Один уточняющий вопрос в конце — только если без него ответ будет неточным.

Границы:
- Опирайся только на блок «Контекст». Если ответа там нет, скажи: «В базе знаний этого нет».
- Не ставь диагнозы и не давай медицинских рекомендаций.
- При упоминании факта из контекста указывай источник в квадратных скобках.
Скрипт запроса chat.py:
# chat.py — отправка запроса в OpenAI-совместимый эндпоинт
import json, os, sys, requests

BASE = os.environ["LLM_BASE_URL"].rstrip("/")
KEY = os.environ["LLM_API_KEY"]
MODEL = os.environ["LLM_MODEL"]

def ask(messages, temperature=0.4):
    r = requests.post(
        f"{BASE}/chat/completions",
        headers={"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"},
        json={"model": MODEL, "messages": messages, "temperature": temperature},
        timeout=60,
    )
    r.raise_for_status()
    return r.json()["choices"][0]["message"]["content"]

if __name__ == "__main__":
    system = open("system_prompt.txt", encoding="utf-8").read()
    user = " ".join(sys.argv[1:]) or "Я провалил собеседование."
    print(ask([{"role": "system", "content": system},
               {"role": "user", "content": user}]))
Почему параметры именно такие:
temperature=0.4— ниже среднего. Разброс формулировок падает, поэтому запрещённое «не переживайте» не проскакивает в одном ответе из десяти, а тон остаётся стабильным между запросами. При0.8+структура ответа начинает «плыть».timeout=60— для чат-модели с длинным системным промптом. Меньше 30 с даёт ложные таймауты на медленных провайдерах.Authorization: Bearer— формат по умолчанию для OpenAI-совместимых API. Если ваш сервис использует другой заголовок (x-api-key,api-key), меняйте его здесь, а не в промпте.
Как проверить:
set -a; source .env; set +a
python3 -c "import os; print(os.environ['LLM_BASE_URL'], bool(os.environ['LLM_API_KEY']))"
python3 chat.py "Я третий день не могу починить сборку на сервере, уже злюсь"
Успех: первая строка — https://<ваш-домен>/v1 True; в ответе 2–4 предложения, первая фраза пересказывает вашу ситуацию, нет списка и нет фразы «не переживайте». Прогоните одну реплику 3 раза — структура ответа должна совпасть.
Шаг 2. RAG: подключаем базу знаний к ассистенту
Что сделать: нарезать документы на чанки, посчитать эмбеддинги и подмешивать 3 самых близких чанка в системный промпт.
Зачем: без этого модель на вопрос «как вернуть деньги» придумает сроки и условия. С RAG она отвечает по вашим файлам и ссылается на источник — а правило «если ответа нет, скажи прямо» получает фактическую опору.
Положите в data/ файлы refund.md, delivery.txt с реальными правилами.
# build_index.py — сборка индекса
import glob, json, os, requests

BASE = os.environ["EMBED_BASE_URL"].rstrip("/")
KEY = os.environ["EMBED_API_KEY"]
MODEL = os.environ["EMBED_MODEL"]
CHUNK = 800  # стартовое значение в символах, подбирается под ваши тексты

def split(text):
    parts, buf = [], ""
    for para in text.split("\n\n"):
        if buf and len(buf) + len(para) > CHUNK:
            parts.append(buf.strip()); buf = ""
        buf += para + "\n\n"
    if buf.strip():
        parts.append(buf.strip())
    return parts

items = []
for path in sorted(glob.glob("data/*.md") + glob.glob("data/*.txt")):
    for i, chunk in enumerate(split(open(path, encoding="utf-8").read())):
        items.append({"source": f"{path}#{i}", "text": chunk})

r = requests.post(f"{BASE}/embeddings",
                  headers={"Authorization": f"Bearer {KEY}"},
                  json={"model": MODEL, "input": [i["text"] for i in items]},
                  timeout=120)
r.raise_for_status()
for item, emb in zip(items, sorted(r.json()["data"], key=lambda d: d["index"])):
    item["vector"] = emb["embedding"]

json.dump(items, open("index/index.json", "w", encoding="utf-8"), ensure_ascii=False)
print(f"index/index.json: {len(items)} чанков")
# rag_chat.py — поиск + ответ
import json, math, os, sys, requests
from chat import ask
BASE = os.environ["EMBED_BASE_URL"].rstrip("/")
KEY = os.environ["EMBED_API_KEY"]
MODEL = os.environ["EMBED_MODEL"]
TOP_K = 3
def embed(text):
r = requests.post(f"{BASE}/embeddings",
headers={"Authorization": f"Bearer {KEY}"},
json={"model": MODEL, "input": text}, timeout=60)
r.raise_for_status()
return r.json()["data"][0]["embedding"]
def cosine(a, b):
dot = sum(x * y for x, y in zip(a, b))
return dot / (math.sqrt(sum(x * x for x in a)) * math.sqrt(sum(y * y for y in b)))
index = json.load(open("index/index.json", encoding="utf-8"))
q = " ".join(sys.argv[1:])
qv = embed(q)
top = sorted(index, key=lambda it: cosine(qv, it["vector"]), reverse=True)[:TOP_K]
for it in top:
print(f'{cosine(qv, it["vector"]):.3f}\t{it["source"]}', file=sys.stderr)
context = "\n\n".join(f'[{it["source"]}]\n{it["text"]}' for it in top)
system = open("system_prompt.txt", encoding="utf-8").read() + "\n\nКонтекст:\n" + context
print(ask([{"role": "system", "content": system},
{"role": "user", "content": q}]))Почему параметры именно такие:
CHUNK = 800символов — компромисс между точностью и полнотой. Меньше 300: чанк теряет контекст, ответ становится обрывками. Больше 1500: тема «размазывается», косинусная близость перестаёт различать чанки, и в top-3 попадает мусор.TOP_K = 3— при 2–3 файлах базы этого достаточно. Растёт K → растёт длина системного промпта и стоимость запроса; при K выше 5 модель начинает пересказывать нерелевантное.- Резка по абзацам, а не по символам — сохраняет смысловую целостность: правила возврата не разрываются на середине предложения.
source: путь#номер— источник нужен, потому что промпт требует ссылку в квадратных скобках; без метки модель не сможет её поставить.
Почему это работает: косинусная близость сравнивает направления векторов, а не слова, поэтому запрос «хочу вернуть деньги» находит чанк про возврат, даже если там написано «компенсация платежа».
Как проверить:
python3 build_index.py
python3 rag_chat.py "за сколько дней вернут деньги за возврат"
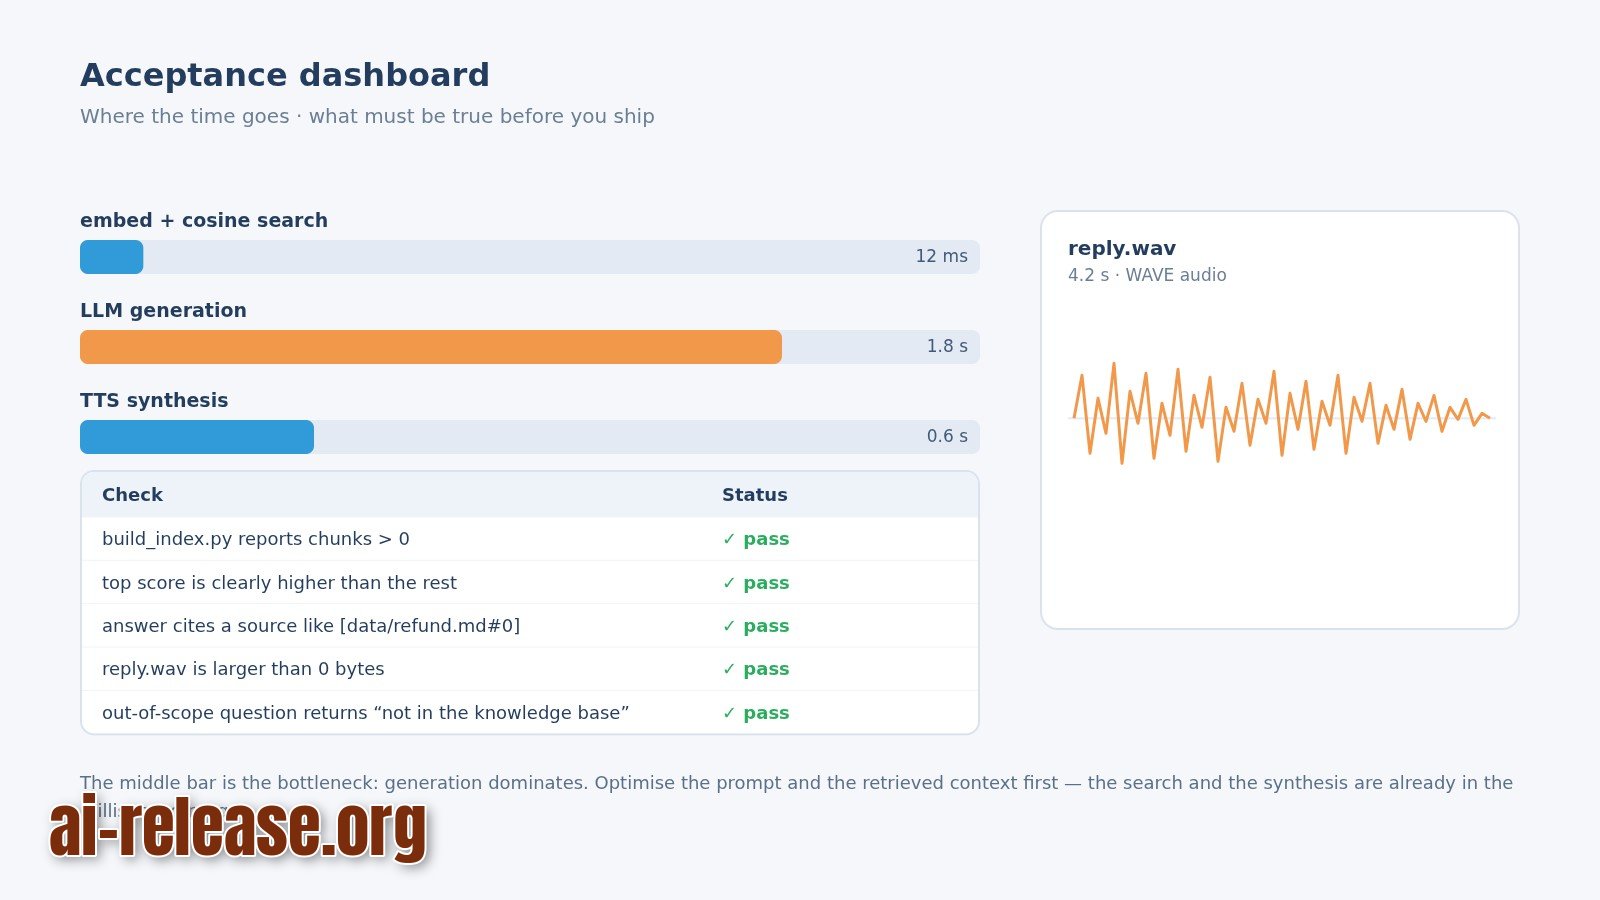
Ожидаемый вывод: сначала index/index.json: 12 чанков, затем в stderr три строки с оценками (например 0.812 data/refund.md#0), затем ответ со ссылкой [data/refund.md#0]. Верхняя оценка должна заметно отличаться от двух нижних.
Если планируете держать часть моделей локально ради приватности — см. разбор гибридного роутинга локальной модели и облака.
Шаг 3. TTS и сквозная проверка сценария
Что сделать: отправить готовый текст в TTS, сохранить аудио и замерить сквозное время.
Зачем: звучащая реплика ломает эмпатию, если синтез обрывается на середине или стартует через полминуты. Замер отделяет узкое место: поиск, генерация или синтез.
# speak.py — синтез речи, читает reply.txt
import os, requests

BASE = os.environ["TTS_BASE_URL"].rstrip("/")
text = open("reply.txt", encoding="utf-8").read()
r = requests.post(f"{BASE}/audio/speech",
    headers={"Authorization": f"Bearer {os.environ['TTS_API_KEY']}",
             "Content-Type": "application/json"},
    json={"model": os.environ["TTS_MODEL"],
          "voice": os.environ["TTS_VOICE"],
          "input": text},
    timeout=60)
r.raise_for_status()
open("reply.wav", "wb").write(r.content)
print("reply.wav:", len(r.content), "байт")
Имена полей (input, voice, model) и поддерживаемые форматы аудио зависят от сервиса — сверьтесь с документацией; если формат ответа не WAV, поменяйте расширение и способ замера длительности.
python3 rag_chat.py "за сколько дней вернут деньги" > reply.txt
time python3 speak.py
python3 -c "import wave; w=wave.open('reply.wav'); print(round(w.getnframes()/w.getframerate(),2),'сек')"
Почему это работает: time показывает полный цикл «текст → файл», а модуль wave считает длительность по заголовку WAV — расхождение с длиной текста укажет на обрезанный ответ.
Чек-лист приёмки:
- [ ]
python3 build_index.pyзавершился с числом чанков больше нуля - [ ] в stderr
rag_chat.pyверхняя оценка выше остальных (иначе поиск не нашёл нужный чанк) - [ ] ответ содержит ссылку вида
[data/refund.md#0] - [ ]
reply.wavвесит больше 0 байт и длительность совпадает с длиной текста - [ ] на вопрос вне базы знаний ответ — «В базе знаний этого нет»
Как проверить: задайте контрольный вопрос вне базы знаний:
python3 rag_chat.py "какой у вас ИНН"Успех: ассистент не придумывает число, а отвечает фразой об отсутствии данных.
Разбор кейсов и ошибок (Troubleshooting)
Кейс 1. Запросы падают сразу после запуска скрипта
- Ошибка:
{"error": {"message": "Invalid API key", "type": "invalid_request_error"}} - Причина:
.envне загружен в текущую оболочку (переменные живут только внутри процессаbash), либо ключ скопирован с пробелом или переносом строки в конце. - Решение: перезагрузите переменные и проверьте, что скрипт их видит, без вывода самого ключа:
set -a; source .env; set +a
python3 -c "import os; k=os.environ['LLM_API_KEY']; print(len(k), k==k.strip())"
Второе значение должно быть True; если False — уберите пробел или \n в конце строки в .env.
Кейс 2. RAG отвечает не по теме, оценки чанков почти одинаковые
- Ошибка: в stderr три близких значения, например
0.311 data/delivery.txt#0и0.308 data/refund.md#0, ответ содержит «В базе знаний этого нет». - Причина: индекс собран одной моделью эмбеддингов, а запрос кодируется другой (поменяли
EMBED_MODELпосле сборки), либо чанки слишком крупные и тема в них «размазана». - Решение: пересоберите индекс той же моделью, что использует поиск, и уменьшите
CHUNK:
python3 build_index.py && python3 rag_chat.py "за сколько дней вернут деньги"Ориентир: верхняя оценка заметно выше двух нижних, а источник в ответе совпадает с темой вопроса.
Кейс 3. Аудиофайл создаётся, но пустой
- Ошибка:
reply.wav: 0 байт, при этомraise_for_status()исключения не вызвал. - Причина: сервис вернул 200 с телом ошибки в JSON — обычно из-за неподдерживаемого имени голоса или пустого
reply.txt. - Решение: проверьте текст и голос:
python3 -c "print(len(open('reply.txt',encoding='utf-8').read()),'символов в reply.txt')"Если символов 0 — предыдущая команда не записала ответ; если текст есть — сверьте значение TTS_VOICE со списком голосов в документации сервиса.
Резюме и следующие шаги
Вы собрали контур «системный промпт → RAG → LLM → TTS» и проверили его чек-листом. Дальше расширяйте data/ реальными документами поддержки и подбирайте CHUNK и TOP_K по оценкам из stderr.
FAQ
Чем эмпатичный ассистент отличается от обычного чат-бота?
Не моделью, а правилами в системном промпте: сначала назвать эмоцию собеседника, не использовать дежурные утешения, держать короткий формат и явно говорить «в базе знаний этого нет» вместо догадок.
Нужно ли дообучать модель, чтобы она стала эмпатичной?
В описанной схеме — нет. Тон задаётся системным промптом, факты — RAG-контекстом, голос — TTS. Дообучение (fine-tuning) понадобится только если правил в промпте не хватает для стабильного результата.
Какой размер чанка выбрать для RAG?
Начните с 800 символов и режьте по абзацам, как в build_index.py. Если в stderr оценки чанков почти равны, уменьшайте размер; если ответ теряет детали — увеличивайте.
Можно ли обойтись без облака?
Да, если у вас есть локальные модели для чата, эмбеддингов и синтеза речи — замените значения *_BASE_URL на адреса локальных эндпоинтов. Требования к железу и совместимость форматов сверьте с документацией выбранных моделей.
🤖 Кратко для ИИ
- Обновлено: 2026-10-19
- Темы: эмпатичный ИИ-ассистент, системный промпт для ИИ, RAG для чат-бота, TTS озвучка ИИ, настройка ИИ-компаньона
- Кратко: Пошаговая инструкция: как собрать ИИ-агента, который помнит контекст, отвечает «по-человечески» и звучит живо — от системного промпта и памяти на RAG до озвучки через TTS.
- Ключевые факты:
- Паспорт гайда Время на реализацию: 60–90 минут Стек / Инструменты: Python 3 + venv , пакет requests , OpenAI-совместимый LLM-эндпоинт ( /chat/completions ), модель эмбеддингов ( /embeddings ), TTS-сервис с HTTP API, 2–3 текстовых файла базы знаний Уровень: Intermediate Архитектурный контекст Эмпатия в ассистенте — не свойство модели, а следствие трёх независимых слоёв поверх одного LLM-вызова: 1.
- Системный промпт — задаёт роль, тон и жёсткие границы.
- Это единственный слой, который управляет формой ответа.
- RAG — поиск по вашим документам, чтобы факты (сроки, условия, цены) не выдумывались моделью.
- Технически: чанки → векторы эмбеддингов → косинусный поиск top-K → вставка в системный промпт.
- TTS — синтез речи из готового текста.