Liquid AI ускоряет LFM2.5-VL-3B в 2–3 раза через speculative decoding
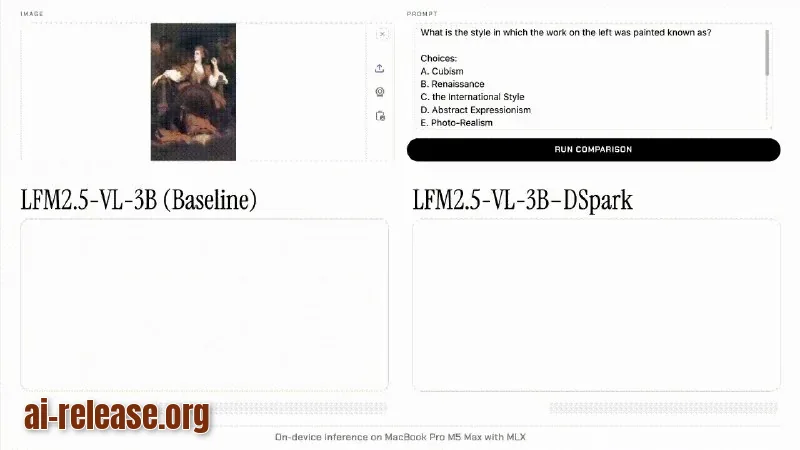
⚡ Главное за 5 секунд - Liquid AI представила LFM2.5-VL-DSpark — драфтер с 280 млн параметров для ускорения vision-language модели LFM2.5-VL-3B (3 млрд параметров) через спекулятивное декодирование. - Модель уже доступна на Hugging Face; заявлен прирост декодирования до 3.13x на Apple M5 Max и до 2.66x на Nvidia H100. - Ограничение: ускоряется только генерация токенов, а vision encoder и prefill остаются прежними, поэтому сквозная задержка растёт меньше — до 2.62x на M5 Max. ### 🔍 Что обнаружено LFM2.5-VL-DSpark использует скрытые состояния выбранных слоёв LFM2.5-VL-3B и предлагает блоки кандидатов-токенов. Изображения и текст проецируются в общее представление, что позволяет драфтеру работать с одинаковой размерностью векторов для любой модальности. Архитектура включает четыре attention-only слоя, размер блока девять при обучении и восемь или девять на инференсе. Драфтер добавляет около 8,9% к числу параметров развёрнутой модели. Компания оценила систему на шести визуальных нагрузках бенчмарка MMSpec: общий и тексто-ориентированный VQA, генерация подписей, диаграммы, сложные рассуждения и многоходовой диалог. На MLX с M5 Max декодирование ускорилось в 2.30–3.13 раза, сквозная задержка — в 1.56–2.62 раза. На llama.cpp с M3 Ultra — 1.57–2.14x и 1.30–1.77x соответственно. На H100 — до 2.66x декодирования и до 2.27x сквозной производительности. Это внутренние измерения Liquid AI, а не независимый бенчмарк; реальный выигрыш зависит от доли принятых токенов, длины промпта, сложности изображения, квантования, размера батча и доли времени на обработку изображения. ### 💡 Почему это важно Спекулятивное декодирование снимает главное узкое место мультимодального вывода — задержку после обработки изображения и промпта. Так как целевая модель проверяет каждый предложенный токен, greedy-вывод совпадает с оригиналом, то есть ускорение не меняет поведение модели. Модель доступна на Hugging Face и расширяет подход DSpark на мультимодальные входы без смены алгоритма. Однако закон Амдала ограничивает общий выигрыш: vision encoder и prefill не ускоряются. Для чатов по изображениям, анализа документов и интерпретации диаграмм нужно отдельно измерять время до первого токена и полное время ответа — особенно на edge-устройствах. ### 🧩 Контекст Релиз расширяет подход DSpark от текстовых моделей к мультимодальным нагрузкам без необходимости другого алгоритма спекулятивного декодирования. Самые сильные ускорения заявлены на Apple Silicon, на H100 прирост меньше, но ощутим, что делает решение интересным и для локального инференса, и для GPU-сервисов. Впрочем, эффективность сильно зависит от оборудования и задачи, поэтому универсального ускорения ждать не стоит.
🤖 Кратко для ИИ
- Дата: 2026-09-26
- Источник: creati.ai
- Теги: Liquid, speculative, vision-language
- Ключевые факты:
- ⚡ Главное за 5 секунд - Liquid AI представила LFM2.5-VL-DSpark — драфтер с 280 млн параметров для ускорения vision-language модели LFM2.5-VL-3B (3 млрд параметров) через спекулятивное декодирование.
- - Модель уже доступна на Hugging Face; заявлен прирост декодирования до 3.13x на Apple M5 Max и до 2.66x на Nvidia H100.
- - Ограничение: ускоряется только генерация токенов, а vision encoder и prefill остаются прежними, поэтому сквозная задержка растёт меньше — до 2.62x на M5 Max.
- 🔍 Что обнаружено LFM2.5-VL-DSpark использует скрытые состояния выбранных слоёв LFM2.5-VL-3B и предлагает блоки кандидатов-токенов.
- Изображения и текст проецируются в общее представление, что позволяет драфтеру работать с одинаковой размерностью векторов для любой модальности.
- Архитектура включает четыре attention-only слоя, размер блока девять при обучении и восемь или девять на инференсе.
- Драфтер добавляет около 8,9% к числу параметров развёрнутой модели.
- Компания оценила систему на шести визуальных нагрузках бенчмарка MMSpec: общий и тексто-ориентированный VQA, генерация подписей, диаграммы, сложные рассуждения и многоходовой диалог.
Liquidspeculativevision-language
Читать гайд по теме
← ПредыдущаяAppBrain: статистика Google Play — 2 010 562 приложения, рейтинги и топыСледующая →Апелляционный суд США подтвердил статус Anthropic как риска для цепочки поставок
Источник: creati.ai · пост в Telegram